时间序列生成需要同时处理长序列建模、生成效率与多尺度结构。围绕这些问题,我们近期开展了两项研究:已被 NeurIPS 2026 接收的 SDFlow,以及最新发布的 arXiv 预印本 UniFlow。两篇工作分别从潜空间生成动力学和多尺度表示出发,探索高效的非自回归时间序列生成。
SDFlow: Similarity-Driven Flow Matching for Time Series Generation
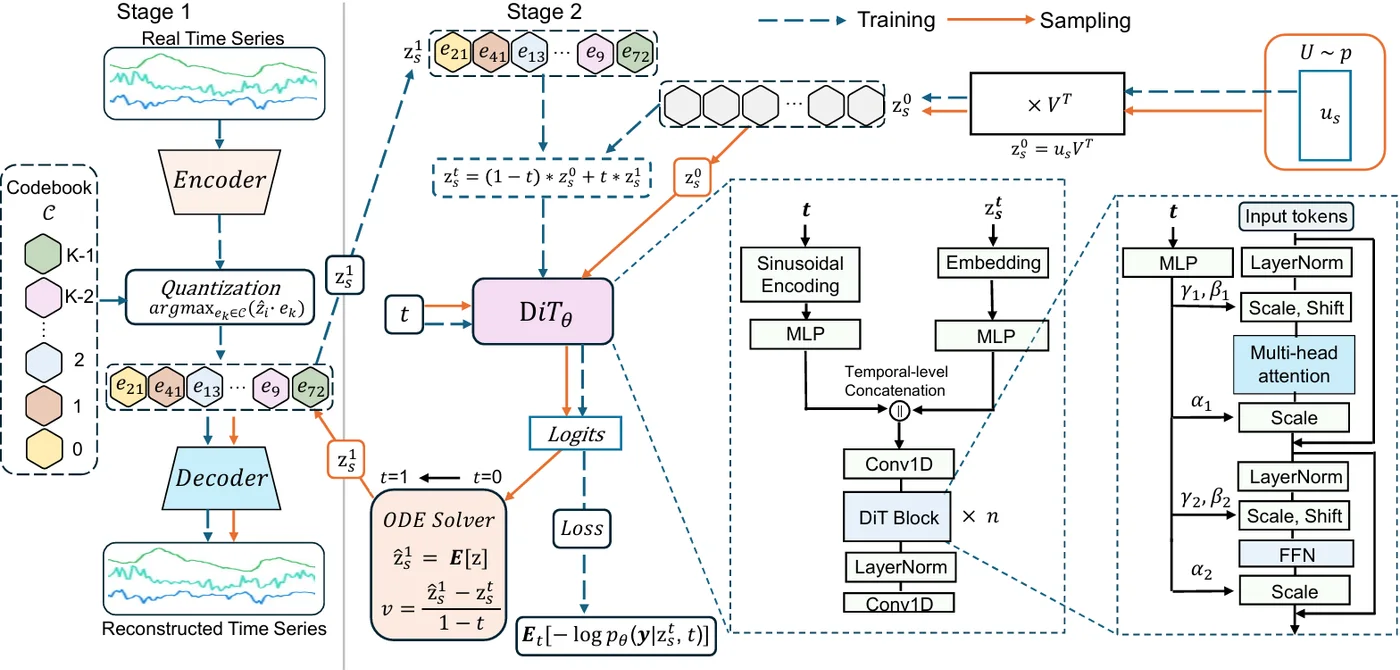
SDFlow 是一个在冻结 VQ 潜空间中进行时间序列生成的非自回归流匹配框架。针对自回归 token 建模中训练与推理条件不一致所带来的误差累积,以及高维潜空间与数据内在低维结构之间的几何失配,该方法结合低秩流形分解与锚点初始化,为生成过程提供具有数据几何结构的起点,并通过整体传输实现序列的并行生成。
在建模上,SDFlow 引入码本索引上的类别后验,将离散 token 的监督信号与连续潜空间中的流匹配相连接。该设计保留了 VQ 表示的离散结构,同时利用连续生成动力学对整段序列进行联合建模。论文在短序列与长序列生成任务中评估了生成质量,并分析了相对于自回归基线的推理效率。
UniFlow: Unified Multi-Scale Flow Matching for Time Series Generation
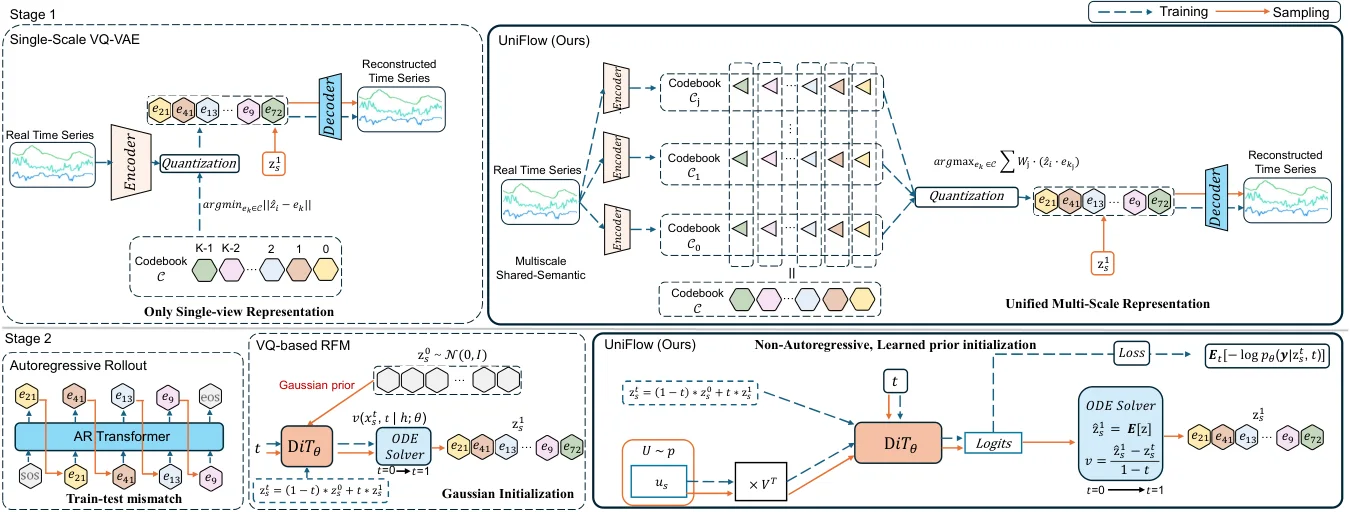
UniFlow 研究如何在控制生成复杂度的同时,将互补的多尺度时序信息引入生成建模。其多尺度 tokenizer 通过共享索引投票,将对齐的多尺度表示整合为单一公共 ID 序列;各尺度保留独立码本,以保存重建所需的尺度特定信息。由此,生成器能够通过统一的 token 接口使用多尺度信息,无需为不同尺度分别建模多条生成序列。
在统一表示的基础上,UniFlow 采用几何感知的类别流匹配,以学习得到的低秩锚点初始化传输,并非自回归地生成公共 ID,再检索各尺度的码本表示完成解码。论文在四个基准数据集的短序列与长序列设置下,从生成保真度、跨尺度一致性与推理效率等方面进行了实验评估。
如果你正在开展时间序列生成、离散潜空间建模或多尺度生成研究,欢迎阅读这两篇论文。如果相关方法和思路对你的研究有所帮助,也欢迎引用。